Camunda-7-Migration: Neue Engine, alte Abhängigkeit?
Die Camunda 7 Community Edition hat ihr End-of-Life erreicht, und jedes Team, das sie betreibt, muss sich für eine neue Engine entscheiden. Wer dabei nur die Engine tauscht, aber die alte Kopplung und Komplexität behält, nimmt seine Tech Debt bloß mit in die neue Version. Dieser Post zeigt, warum die Migration eine seltene Chance ist, stattdessen beides abzubauen.

Die Camunda 7 Community Edition hat im Oktober 2025 ihr End-of-Life erreicht, und 7.24 war das letzte Minor-Release. Enterprise-Kunden bekommen höchstens bis 2032 noch Patches und stehen damit weniger unter Druck. Ein neues Camunda 7 erscheint aber auch für sie nicht mehr. Früher oder später muss deshalb jedes Team, das Camunda 7 einsetzt, über die Zukunft seiner Prozessautomatisierung entscheiden.
Dafür gibt es mehrere Optionen: vorerst auf Camunda 7 bleiben, zu einem weitgehend kompatiblen Fork wie CIB seven, Operaton oder Fluxnova wechseln, auf Camunda 8 umsteigen (eine grundlegend andere Engine, die nur remote läuft) oder gleich eine ganz andere Engine wählen.
Hinter dieser Entscheidung steckt noch eine zweite, die leicht untergeht. Nimmst du bei der Migration deine bisherige Kopplung an die Engine und die darum gewachsene Komplexität einfach mit? Oder lässt du beides zurück? Wer nur die Engine tauscht, migriert seine Tech Debt gleich mit. Wer stattdessen die Kopplung abbaut, gewinnt langfristig Flexibilität zurück.
Deshalb sehe ich in dieser unfreiwilligen Migration eine seltene Chance zur Modernisierung. Und in diesem Post erkläre ich, warum du sie genau dafür nutzen solltest.
🕸️ Wo sich der Engine-Lock-in versteckt
Wer heute Camunda 7 betreibt, steht vor der Wahl, zu welcher Engine er wechseln will. Auf den ersten Blick wirkt ein Fork am verlockendsten. Die APIs bleiben weitgehend gleich, und die Konzepte, die du kennst, gelten weiterhin. Der Handlungsdruck scheint gering, das unmittelbare Migrationsrisiko ebenso. Im einfachsten Fall aktualisierst du deine Dependencies, passt die Package-Imports an, und die Anwendung startet wieder. Das ist ein echter Vorteil.
Genau darin liegt aber auch der blinde Fleck. Ein Fork zwingt dich nicht, dir die Kopplung anzusehen, die sich über die Jahre in deinem Code angesammelt hat. Dabei entscheidet diese Kopplung, wie teuer deine nächste Migration wird. Welche Engine du wählst, spielt eine viel kleinere Rolle.
Allerdings bleibt Kopplung abstrakt, solange du sie nicht im eigenen Code siehst. Deshalb zieht sich ein Beispiel durch den ganzen Post: ein Prozess für Fahrradleasing. Auf derselben Domäne bauen auch unsere Miragon-Blueprints auf. An diesem Beispiel zeige ich dir die zwei Formen von Kopplung, die mir in Camunda-7-Projekten regelmäßig begegnen.
Bei der ersten Form geht es darum, wie dein Code organisiert ist: Geschäftslogik ist nach und nach mit der Engine verwachsen. Zwei Muster tauchen dabei immer wieder auf.
Das eine sind Engine-Callbacks, in denen sich mit der Zeit Geschäftslogik ansammelt. Implementierungen von JavaDelegate, ExecutionListener und TaskListener sind anfangs reiner Glue-Code. Doch irgendwann landet echte Fachlogik darin.
class ValidateApplicationDelegate : JavaDelegate {

    override fun execute(execution: DelegateExecution) {
        val application = execution.getVariable("application") as LeasingApplication
        if (application.monthlyNetIncome <= 0.0) {
            throw BpmnError("applicationInvalid", "monthly net income must be greater than zero")
        }
    }
}
Dieser Delegate prüft einen Leasingantrag, und die Prüfregel steckt direkt darin. Aufrufen oder testen kannst du ihn nur über die DelegateExecution der Engine. Außerdem speichert die Engine den Antrag selbst als Objektvariable. Damit hängt sogar das Format deiner Daten von ihren Serializern ab.
Das andere Muster funktioniert genauso, nur in umgekehrter Richtung: Dein eigener Code ruft die Service-APIs der Engine direkt auf. Startet etwa ein @RestController den Leasingprozess über den RuntimeService, bindet dich dieser Aufruf an die API der Engine, genau wie der Delegate. Und diese API ist umfangreich und ganz auf diese Engine zugeschnitten. RuntimeService, TaskService und HistoryService bringen jeweils eigene Queries und ein eigenes Bild davon mit, wie die Engine funktioniert. Meiner Erfahrung nach verteilen sich solche Aufrufe mit der Zeit über den ganzen Code, bis die Engine überall auftaucht.
Bei der zweiten Form geht es um Engine-spezifische Features. Also um alles, was nur diese Engine kann. Das Problem ist hier nicht, wo dein Code steckt, sondern dass eine andere Engine das Feature vielleicht gar nicht unterstützt.
Die hartnäckigsten Abhängigkeiten dieser Art sind mir bisher in Process Engine Plugins begegnet. Nehmen wir an, die Compliance will jeden Schritt des Leasingprozesses in einem Audit-Trail sehen. Also schreibt jemand einen eigenen History Event Handler, der jedes Event in deine Reporting-Datenbank schiebt. Dieser Handler greift direkt in die Interna der Engine ein. Deshalb kann ihn keine andere Engine ausführen.
Bei User Tasks ist es genauso. Stell dir vor, eine Sachbearbeiterin prüft jeden Antrag in einem User Task. Baust du dafür eine eigene UI, liegt es nahe, die Tasks direkt über die API der Engine abzufragen und abzuschließen, samt ihren Formularen und den Einstellungen in deinem Modell. Im einfachsten Fall baust du vielleicht gar keine eigene UI und lässt deine Nutzer gleich in der Tasklist-App der Engine arbeiten. Dann bist du doppelt an die Engine gekoppelt: im Backend und im Frontend.
Und das ist noch nicht alles, worauf du achten solltest. Parse Listener können BPMN-Modelle beim Deployment umschreiben. Oder deine Geschäftslogik verlässt sich darauf, wie diese Engine mit Incidents, Retries und Transaktionen umgeht. Reports greifen womöglich direkt auf die Tabellen der Engine zu. Und eine Embedded Engine gibt dir sogar die Spring-Boot- und Java-Versionen vor. Erscheinen für deine Edition keine Releases mehr, hängst du damit auch bei den Framework-Upgrades fest.
Prüf dabei aber nicht nur die Engine, die du heute betreibst. Schau dir auch die an, zu der du wechseln willst. Camunda 8 etwa bietet einen Marketplace voller fertiger Connectors, zum Beispiel für Slack oder Salesforce. Du konfigurierst sie direkt im Modell, fast ohne eigenen Code. Für Teams, die eher auf Low-Code setzen, kann das sehr wertvoll sein. Allerdings steckt die Integration dann in deinem Prozessmodell, und ausführen kann sie nur Camunda 8.
Die Symptome unterscheiden sich, das Prinzip bleibt gleich: Je stärker du dich auf solche Dinge stützt, desto schwerer fällt der Wechsel zu einer anderen Engine.
⚠️ Warum ein kompatibler Fork die Schulden nicht tilgt
Diese ganze Kopplung ist Tech Debt. Und ein Fork übernimmt sie unverändert, denn genau das verspricht er ja. Du bist wieder auf einer unterstützten Version, und das fühlt sich nach Fortschritt an. Das eigentliche Problem zieht aber einfach mit um.
Der Fork ist daran nicht schuld. Er gibt dir nur weniger Anlass, dich um die Schulden zu kümmern. Camunda 8 dagegen unterscheidet sich an zu vielen Stellen, als dass du eins zu eins migrieren könntest. Du musst deinen Code also ohnehin anfassen. Natürlich kannst du dabei dieselbe Kopplung wieder einbauen. Aber immerhin schaust du sie dir noch einmal an. Beim Fork fehlt sogar dieser Anstoß.
Doch Kopplung ist nur der sichtbare Teil der Schulden. Darunter liegt, was jedes langlebige System über die Jahre ansammelt: Komplexität. Jeder Quick Fix, jeder Sonderfall und jeder Workaround macht das System ein bisschen komplexer. Schon Lehman hat beobachtet: Komplexität wächst immer weiter, solange niemand gezielt daran arbeitet, sie zu reduzieren. Tauschst du nur die Dependency aus, schiebst du diese Arbeit erneut auf.
Und wie alle Schulden kosten auch diese Zinsen. Jede Änderung dauert etwas länger als die vorherige. Gleichzeitig verstehen immer weniger Leute, warum das System so gebaut ist, wie es ist. Am Ende wissen es nur noch die wenigen, die es entwickelt haben. Peter Naur nannte dieses Wissen die Theorie eines Programms. Geht das Team, das diese Theorie im Kopf hat, ist das Programm tot, auch wenn es noch läuft.
Ein Wechsel der Dependency tilgt nichts von diesen Schulden. Er verschiebt sie samt Zinsen nur auf eine neue Engine. Die Zinsen wachsen weiter. Dein Team reagiert auf jede neue Anforderung langsamer, bis sich niemand mehr traut, den Prozess anzufassen. Dann gilt „Never change a running system“, und die Schulden kosten dich mehr als Zeit. Sie kosten dich deine Innovationsfähigkeit.
Löst du dagegen Logik aus der Engine heraus, hast du die Chance, die Schulden abzubauen. Denn wer diesen Code verschiebt, muss ihn erst wieder verstehen. Mit jedem Stück, das du abträgst, gewinnt dein Team Zeit für deine Geschäftsprozesse statt für die Plattform, auf der sie laufen.
Ein Fork bringt dir also Aufschub, aber keine architektonische Freiheit.
🧭 Nutze die Migration als Gelegenheit zur Modernisierung
Diese Freiheit kommt nicht von der Engine, die du wählst. Entscheidend ist, wie wenig von deiner Geschäftslogik an ihr hängt. Gib dich also nicht damit zufrieden, dass deine Anwendung auf der neuen Engine läuft. Sorg dafür, dass sie an keine Engine mehr eng gebunden ist.
Dazu ziehst du eine klare Linie. Auf der einen Seite landet deine Logik in ganz normalem Code, der nicht weiß, dass es überhaupt eine Engine gibt. Auf der anderen spricht nur eine dünne Schicht Glue-Code mit der Engine. Umschreiben musst du nur den Code, der heute direkt an der Engine hängt, nicht deine Prozesse und nicht deine Domäne.
Zieh diese Linie schon auf deiner heutigen Engine, nicht erst auf der neuen. Geh dabei Schritt für Schritt vor: erst einen Delegate, dann einen Aufruf des RuntimeService und so weiter. Alter und neuer Code laufen so lange nebeneinander, bis der alte Code verschwunden ist. Martin Fowler nennt dieses Vorgehen das Strangler-Fig-Pattern. Jedes Stück, das du herauslöst, bekommt eigene Tests. Erst danach wechselst du die Engine. So weißt du bei einem Fehler, welche Änderung schuld war. Und weil die Tests das Aufräumen absichern, kannst du endlich die Sonderfälle rauswerfen, die niemand mehr braucht. Das senkt die Komplexität deines Systems.
Je nach Größe deiner Services und Prozesse ist das alles ein ordentlicher Aufwand. Mit KI-Coding-Assistenten, die gerade bei solchen Refactorings immer besser werden, lässt er sich aber gut stemmen.
Trotzdem lohnt es sich nicht immer. Hängt deine Anwendung nur an wenigen Stellen an der Engine und wird ohnehin bald abgelöst, sind ein Fork und ein Versionssprung der pragmatische Weg. Die Trennung zahlt sich aus, wenn deine Prozesse langfristig bleiben. Genau dann empfehle ich dir den folgenden Ansatz.
🛡️ Halte Geschäftslogik aus der Engine heraus
Ein bewährter Weg, diese Trennung im Code umzusetzen, ist die hexagonale Architektur, auch bekannt als Ports and Adapters. Vielleicht kennst du die Idee auch unter dem Namen Onion oder Clean Architecture. Im Detail unterscheiden sich die Ansätze etwas, im Kern sind sie aber gleich: Die Domäne steht im Zentrum, die Engine bleibt am Rand. Ich nutze hier die hexagonale Variante.
Dabei definiert deine Domäne einen Use Case in ihrer eigenen Sprache. Die Engine erreicht die Domäne nur von außen, über dünne Adapter. Deshalb importiert die Domäne die Engine nie. Das gilt in beide Richtungen: ob die Engine deinen Code aufruft oder dein Code die Engine.
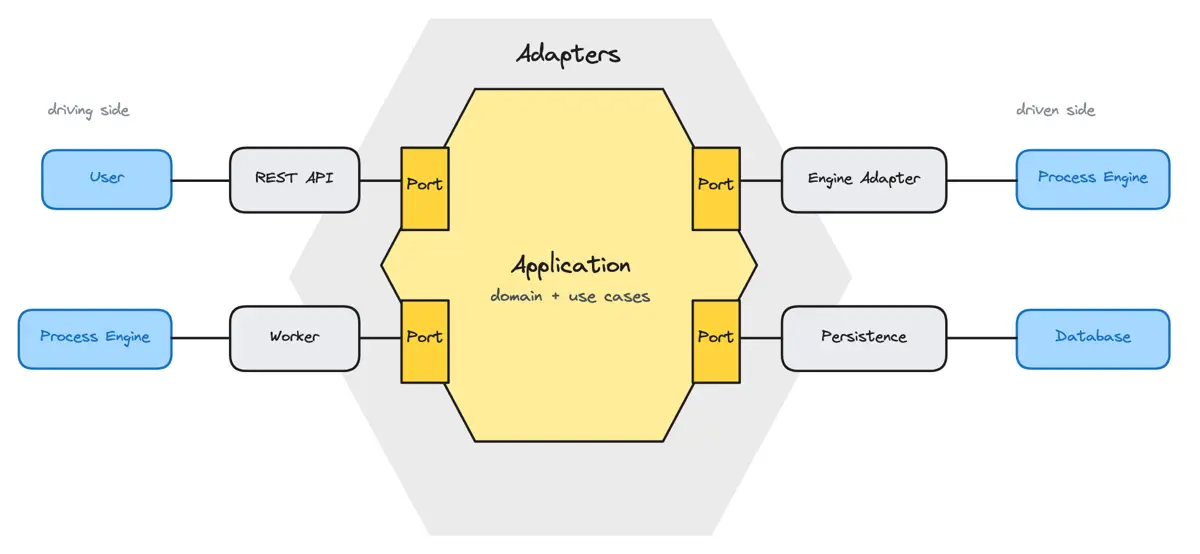
Baust du den ValidateApplicationDelegate von vorhin nach diesem Prinzip um, besteht die treibende Seite, auf der die Engine deinen Code aufruft, aus drei Teilen. Alle drei stammen, leicht gekürzt, aus einem unserer Blueprints mit Embedded Engine und sind in Kotlin geschrieben.
Zuerst legt die Domäne in einem Interface fest, was sie kann. Das ist der Port zur Geschäftslogik. Dann implementiert ein Service dieses Interface. Er lädt den Antrag aus deiner eigenen Datenhaltung. Die Engine muss ihn also nicht mehr speichern. Die Regel selbst wandert in die Methode LeasingApplication.validate(). Sie wirft eine ApplicationInvalidException, wenn das monatliche Nettoeinkommen nicht größer als null ist. Das alles ist ganz normaler Kotlin-Code, und weit und breit ist keine Engine zu sehen:
// ValidateApplicationUseCase.kt
interface ValidateApplicationUseCase {
    fun validate(id: ApplicationId)
}

// ValidateApplicationService.kt
class ValidateApplicationService(
    private val repository: LeasingApplicationRepository,
) : ValidateApplicationUseCase {

    override fun validate(id: ApplicationId) {
        val application = repository.findById(id) ?: error("Unknown application $id")
        application.validate()
    }
}
Zum Schluss wird der Delegate zu einem schlanken Adapter. Er liest die ID aus der Engine, ruft den Use Case auf und macht aus einer fachlichen Exception einen BPMN-Error:
class ValidateApplicationDelegate(
    private val useCase: ValidateApplicationUseCase,
) : JavaDelegate {

    override fun execute(execution: DelegateExecution) {
        try {
            useCase.validate(ApplicationId.of(execution.getVariable("applicationId") as String))
        } catch (e: ApplicationInvalidException) {
            throw BpmnError("applicationInvalid", e.reason)
        }
    }
}
Jetzt läuft die Regel ohne Engine, du kannst sie also direkt per Unit-Test prüfen. Die Engine speichert nur noch eine ID und die wenigen einfachen Werte, nach denen deine Gateways verzweigen. Das bekommt jede Engine hin. In bereits laufenden Instanzen steckt allerdings noch die alte Objektvariable. Lass diese Instanzen entweder mit dem alten Code auslaufen oder migriere ihre Daten vorher.
Bei dieser Lösung ist der Delegate die einzige Stelle, die die Engine kennt, und er tut nichts anderes, als zu übersetzen. Wechselst du die Engine, fasst du im Code also nur diesen Adapter an. Dein BPMN und deine Expressions musst du vielleicht trotzdem anpassen, deine Domäne aber nicht.
🧩 Setz auf das, was alle Engines gemeinsam haben
Die Trennung allein macht deinen Code allerdings noch nicht portabel. Es kommt auch darauf an, welche Engine-Features deine Glue-Schicht durchreicht. Camunda 7, seine Forks und Camunda 8 implementieren jeweils nur einen Teil der BPMN-2.0-Spezifikation. Sie teilen sich aber einen ausführbaren Kern.
Jede dieser Engines startet Prozesse, führt Service Tasks aus, steuert User Tasks, korreliert Messages und verarbeitet Signale. Die meisten Engines können zusätzlich Entscheidungen auswerten, die mit DMN modelliert sind. Dass sie diesen Kern auch identisch ausführen, garantiert dir jedoch niemand. Selbst die BPMN Model Interchange Working Group der OMG prüft nur, ob sich BPMN-Modelle sauber zwischen den Tools verschiedener Hersteller austauschen lassen, nicht aber, wie Engines sie ausführen. Trotzdem bleibt diese Schnittmenge dein kleinster gemeinsamer Nenner.
Über diese Schnittmenge hinaus bringt jedes Produkt eigene Extras mit, etwa die aus dem Abschnitt zum Lock-in. Sie sind mächtig, und manchmal brauchst du sie wirklich. Entscheide hier bewusst. Bleib grundsätzlich beim gemeinsamen Nenner und greif nur dann zu einem Engine-spezifischen Feature, wenn es sich eindeutig lohnt. Und wenn du das tust, kapsle es so weit wie möglich in deiner dünnen Glue-Schicht.
Bei User Tasks gelingt dieses Kapseln noch leicht, denn sie gehören zum gemeinsamen Kern. Engine-spezifisch ist alles, was es darüber hinaus gibt: die Tasklist-App, ihre Formulare und ihre Task-API. Und genau darauf solltest du meiner Erfahrung nach am wenigsten aufbauen. Abstrahiere das also weg. Definiere ein eigenes Task-Modell, das zu deinem Anwendungsfall passt, und lass die Glue-Schicht die Tasks der Engine darauf abbilden. Die Sachbearbeiterin aus dem Lock-in-Beispiel prüft Anträge dann in deiner eigenen UI, die auf diesem Modell basiert. Diese Abstraktion kannst du selbst bauen oder auf einer bestehenden Library wie Polyflow aufsetzen. Das ist anfangs mehr Arbeit, vor allem wenn deine Nutzer bisher in der Tasklist-App der Engine arbeiten. Dafür musst du deine UI beim nächsten Engine-Wechsel nicht anfassen.
Schwieriger wird es bei Plugins und Connectors. Ein Plugin wie der Handler für den Audit-Trail gehört hinter einen eigenen Port, und nur ein dünner Adapter kennt die Engine. Statt eines Connectors schreibst du den Aufruf selbst als Worker. Das ist mehr Code, den du pflegen musst. Aber es ist dein Code, und du kannst ihn auf jede Engine mitnehmen. Trotzdem kann dir der Connector mehr wert sein als die Engine-Unabhängigkeit, etwa wenn der Prozess weniger kritisch ist oder dein Team bewusst auf Low-Code setzt. Dann geh diesen Trade-off ein, aber sehenden Auges.
🔌 Ein Port, der nur kann, was alle Engines können
Noch besser ist es, wenn du diesen Trade-off gar nicht erst abwägen musst. Das gelingt, wenn dein Port zur Engine nur die Schnittmenge anbietet, also nur das, was alle Engines beherrschen. Genau das ist die Idee hinter der Process Engine API der BPM Crafters. Sie ist ein einheitliches, Engine-agnostisches Interface und hört bewusst dort auf, wo die Gemeinsamkeiten aller Engines enden. Damit ist der gemeinsame Nenner nicht mehr nur eine Regel, an die dein Team denken muss. Er steckt im Interface selbst. Wer darüber hinausgeht, tut das mit Absicht und sichtbar, nicht aus Versehen.
Die API funktioniert in beide Richtungen. Mit ihren Commands startet dein Code zum Beispiel Prozesse, korreliert Messages oder sendet Signale. Über Task-Subscriptions bekommen deine Worker ihre Tasks. Adapter gibt es für Camunda 7, Camunda 8, CIB seven und Operaton. Eine Feature-Matrix legt offen, wo welcher Adapter Lücken hat. Die API steht unter der Apache-2.0-Lizenz und wird von Contributors aus mehreren Firmen gepflegt. Du tauschst also nicht die eine Anbieterabhängigkeit gegen die nächste. Der Transparenz halber: Ich arbeite selbst daran mit, meine Begeisterung ist deshalb mit Vorsicht zu genießen.
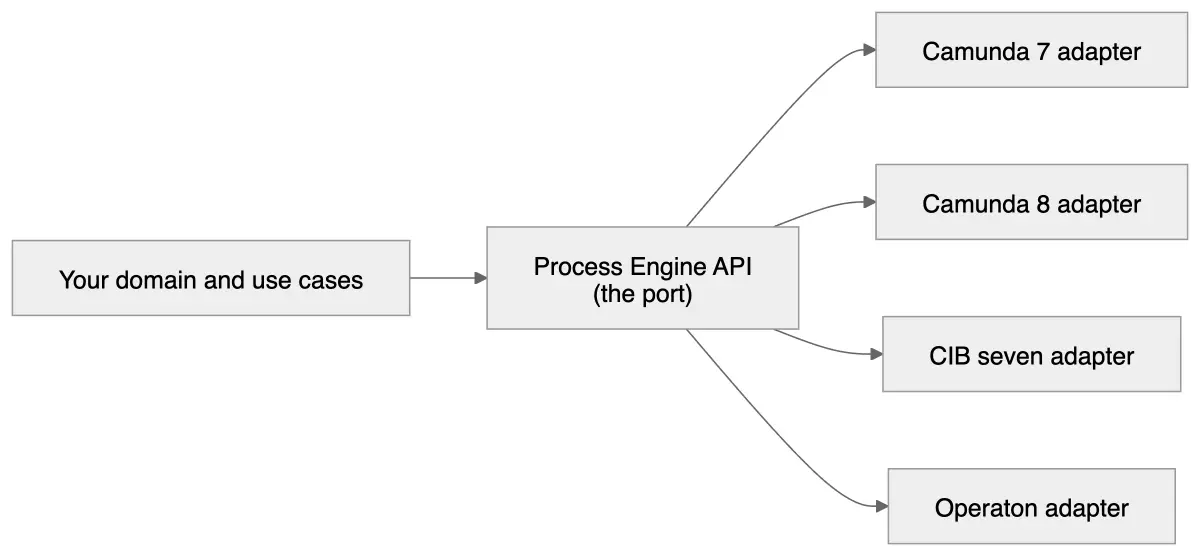
Mit der API und der dazugehörigen Library Process Engine Worker wird aus dem Delegate von oben ein Worker, der nicht mehr weiß, welche Engine ihn aufruft. Das Beispiel stammt aus unserem Blueprint zur Process Engine API, der auch einen kompletten Service mit der API zeigt. So sieht der Worker aus:
@ProcessEngineWorker(topic = "validateApplication")
fun validateApplication(@Variable applicationId: String) {
    try {
        useCase.validate(ApplicationId.of(applicationId))
    } catch (e: ApplicationInvalidException) {
        throw BpmnErrorOccurred(e.reason, "applicationInvalid", emptyMap())
    }
}
Deine Service Tasks verweisen jetzt auf ein Topic statt auf einen Delegate. Wenn du die API einführst, musst du deine Modelle also einmal anfassen. Danach besteht ein Engine-Wechsel aber im Wesentlichen darin, den Adapter zu tauschen: eine andere Dependency und etwas Konfiguration. Deine Domäne bleibt, wie sie ist. Am besten klappt das zwischen den Forks. Für sie gibt es die Adapter jeweils in einer Embedded- und einer Remote-Variante, sodass du genauso zwischen den beiden Setups wechseln kannst. Der Sprung zu Camunda 8 ist anspruchsvoller, funktioniert aber auch.
Für alles, was über die Schnittmenge hinausgeht, baust du einen eigenen Port. Dahinter sitzt ein Adapter, der direkt auf die Engine zugreift und damit wieder Engine-spezifisch ist. Du findest ihn aber leicht, denn außer der Process Engine API kennt nur er die Engine.
🧪 Sichere die Trennung mit Architekturtests ab
Diese Trennung bringt nur etwas, solange sie hält. Und meiner Erfahrung nach wird sie selten absichtlich eingerissen. Da braucht jemand mal eben eine Query, importiert den RuntimeService, und schon landet die Engine wieder in der Domäne. Code-Reviews fangen einiges davon ab, aber nicht alles.
Architekturtests schließen diese Lücke. Tools wie ArchUnit gießen die Trennung in eine Regel, die bei jedem Verstoß den Build fehlschlagen lässt. Nutzt du ausschließlich die Process Engine API, hält eine einzige Regel die Engine aus deinem Anwendungscode heraus:
@Test
fun `only the process engine api talks to the engine`() {
    noClasses()
        .that().resideInAPackage("io.miragon.blueprint..")
        .should().dependOnClassesThat().resideInAPackage("<engine-root-package>..")
        .because("engine access goes through the Process Engine API")
        .check(productionClasses)
}
Brauchst du doch ein Engine-spezifisches Feature wie oben beschrieben, kannst du den zugehörigen Adapter gezielt von der Regel ausnehmen. So bleibt jede Ausnahme eine sichtbare Entscheidung im Code.
⚖️ Wo die Entkopplung endet: Engines unterscheiden sich zur Laufzeit
Auch mit strengen Architekturtests ist volle Unabhängigkeit von deiner Engine jedoch eine Illusion. Eine saubere Trennung senkt deine Wechselkosten, macht Engines aber nicht austauschbar. Manche Änderungen fängt sie nicht ab, etwa wenn du beim Umstieg von Camunda 7 auf Camunda 8 deine BPMN-Modelle anpassen musst. Und die größten Unterschiede zeigen sich zur Laufzeit.
Am deutlichsten wird das beim Wechsel von einer Embedded- zu einer Remote-Engine. Eine Embedded-Engine kann in derselben Transaktion laufen wie dein eigener Code. Ein Prozessschritt und deine Datenbankänderung werden dann entweder gemeinsam committet oder gemeinsam zurückgerollt. Das ist eine starke Garantie. Steigst du auf eine Remote-Engine wie Camunda 8 um, fällt sie weg. Deine Datenbankänderung und der Prozessschritt werden dann getrennt committet. Du hast es also mit Eventual Consistency und neuen Fehlerbildern zu tun. Bernd Rücker beschreibt die Folgen in seinem Post über den Wechsel von Embedded- zu Remote-Engines. Ich habe außerdem über das Distributed-Transaction-Problem geschrieben, das dadurch in Zeebe entsteht, und darüber, wie du damit umgehst.
Einen Teil davon nimmt dir die Library Process Engine Worker schon ab, die du aus dem Worker-Beispiel oben kennst. Er kann einen Task erst dann abschließen, wenn deine eigene Transaktion committet ist. Und seine Idempotency Registry sorgt dafür, dass deine Worker-Logik nur einmal läuft, selbst wenn die Engine denselben Task zweimal ausliefert. Das erleichtert den Wechsel zwischen Embedded und Remote. Um Patterns wie die Outbox kommst du aber nicht herum.
Transaktionen sind nur ein Beispiel. Auch wie Fehler sichtbar werden und wie du die Engine skalierst, ändert sich beim Umstieg. Die Entkopplung beseitigt diese Unterschiede nicht. Aber sie grenzt ein, wo du dich darum kümmern musst: im Code vor allem im Adapter. Der Rest betrifft Architektur, DevOps und Teamorganisation, etwa wo die Engine läuft, wer sie betreibt und wer für Prozessmodelle und Incidents verantwortlich ist. All das solltest du vor dem Wechsel klären, nicht erst danach.
🎯 Was dir die Entkopplung wirklich bringt
Die Unterschiede zur Laufzeit bleiben also bestehen. Trotzdem bringt dir die Trennung eine Menge:
- Eine günstigere nächste Migration: Deine Domäne importiert die Engine nie, und Architekturtests sorgen dafür, dass das so bleibt. Beim nächsten Wechsel tauschst du dann Adapter und passt Modelle an, statt Geschäftslogik neu zu schreiben. Und das verschafft dir Business Agility.
- Testbare Geschäftslogik: Regeln wie die Prüfung des Leasingantrags sind ganz normaler Code. Du testest sie, ohne eine Engine zu starten.
- Weniger Tech Debt, mehr Fokus: Die Workarounds, die sich in deinem Engine-Code angesammelt haben, lässt du hinter dir. Dein Team verbringt also weniger Zeit mit der Plattform und mehr mit den Geschäftsprozessen, die den Wert deines Produkts ausmachen.
- Wissen, das im Team bleibt: Geschäftslogik steckt in einfachem, getestetem Code statt in Engine-Callbacks. So können mehr als eine Handvoll Leute sie verstehen und ändern.
- Bewusst gewählte Engine-Features: Ob du Plugins, Connectors, die Tasklist oder andere Extras nutzt, entscheidest du gezielt. Und wenn du sie nutzt, dann an einer Stelle, die du leicht wiederfindest.
🤝 Fazit
Camunda 7 kostet dich so oder so eine Migration, jetzt oder spätestens 2032. Sorg also dafür, dass sie dir auch etwas bringt. Ob Fork, Camunda 8 oder eine andere Engine: Alle drei sind eine gute Wahl. Abraten würde ich nur davon, es beim bloßen Engine-Tausch zu belassen. Trenn Geschäftslogik und Engine, solange du ohnehin im Code steckst. Dann fällt der nächste Umzug kleiner aus.
Wie so eine Trennung in der Praxis aussieht, zeigen dir die Blueprints oder die Process Engine API selbst. Wenn du eine zweite Meinung zu deinem Migrationspfad einholen möchtest, helfen wir dir gern. Und wenn du die Trade-offs (Embedded oder Remote, Konsistenz, Engine-Unabhängigkeit) lieber mit Leuten durchsprechen willst, die täglich damit arbeiten, schau dir unsere Trainings zu Camunda 8, CIB seven und Operaton an.
Mich interessiert, wie du deine Migration angehst. Setzt du auf einen Fork, auf Camunda 8 oder auf etwas anderes? Und ist sie für dich ein reiner Versionssprung oder eine Chance, deinen Code von der Engine zu entkoppeln?
Fandest du den Artikel interessant?
Abonniere unseren Newsletter und erhalte neue Beiträge direkt ins Postfach.
Das könnte dich auch interessieren
Ähnliche Beiträge aus unseren Insights
Was ist eine Prozessapplikation?
Eine Prozessapplikation ist ein eigenständig deploybares Software-Bundle, das konkrete Fachprozesse einer Domäne ausführt. Dieser Beitrag definiert den Begriff, zeigt die Bestandteile und grenzt ihn von integrativen Prozessen und der zentralen Taskliste ab.

Ausführbar, aber unlesbar: AI-bearbeitete BPMN-Modelle sauber halten
AI schreibt BPMN oft schon im ersten Versuch korrekt. Trotzdem kommt das Diagramm häufig kaputt heraus, denn sie sieht nie, was sie zeichnet. Dieser Post zeigt den Loop aus Erkennen, Beheben und Erzwingen, mit dem ich diese visuelle Lücke schließe. Und die Grenze, die ich dabei ziehe.

Beyond the Happy Path: Was eine Camunda-8-Migration wirklich schwer macht
Warum der Wechsel auf Camunda 8 kein technisches Upgrade ist, sondern eine Plattform-Transformation: Erkenntnisse aus unserem CamundaCon-2026-Vortrag in Amsterdam.
Innerhalb eines Tages weißt du, wo du stehst.
Kein Verkaufsgespräch, sondern eine ehrliche Einschätzung, ob und wie Automatisierung dir hilft.
Erstgespräch vereinbarenKein Commitment. Kein Pitch-Deck. Nur Klarheit.